Quando a rede vira matéria-prima: autoria, consentimento e poder na era da IA
O debate sobre IA e conteúdo deixou de ser sobre quem criou uma obra. Passou a ser sobre quem pode aprender com ela, transformá-la em produto e capturar o valor dessa inteligência.
No mesmo dia, dois continentes
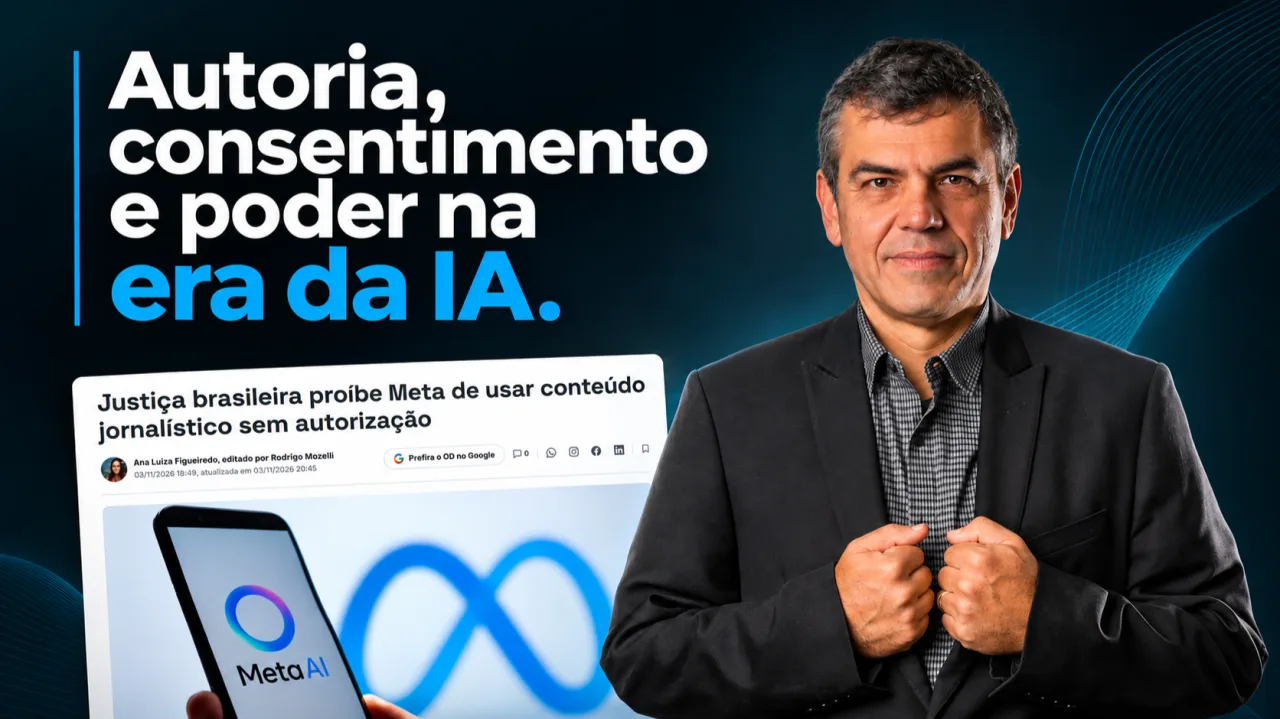
Em 3 de novembro de 2026, duas instituições separadas por um oceano fizeram a mesma pergunta. Em São Paulo, a Justiça concedeu liminar que impede a Meta de exigir de veículos de imprensa uma licença ampla para rastrear, copiar e usar seus conteúdos, inclusive para treinar inteligência artificial.
Em Luxemburgo, o advogado-geral Maciej Szpunar apresentou ao Tribunal de Justiça da União Europeia sua opinião no caso Like Company v. Google, o primeiro a tratar de chatbots e direitos de editores de imprensa.
A coincidência de datas não é acaso de calendário. É sinal de que o tema amadureceu.
A pergunta de fundo é a mesma nos dois lugares: o que acontece com a autoria quando uma obra pode ser coletada em escala, convertida em dado, absorvida por um modelo e devolvida ao público como resposta, resumo ou recomendação?
Para quem acompanha a internet desde seus primeiros anos no Brasil, a cena é familiar. Já discutimos quem é responsável pelo que circula na rede, quem paga pela infraestrutura e quem controla o acesso.
Agora a discussão chega a uma camada mais profunda: quem é dono do repertório que forma as máquinas que passam a mediar nossa relação com a informação.
O que a liminar decidiu e o que ela não decidiu
A decisão paulista atende a uma ação da ANJ, da ABERT e da ANER. Ela proíbe a Meta de condicionar a presença dos veículos associados à aceitação de novos termos que autorizam a coleta e o uso amplo de seus conteúdos. Também veda retaliação contra quem recusar esses termos. A multa é de R$ 1 milhão por dia, limitada a R$ 100 milhões.
O alcance, porém, é específico. A decisão é provisória e pode ser revista. Não proíbe a Meta de usar todo conteúdo jornalístico disponível na internet, nem resolve a questão para os demais usuários das plataformas. Tratar a liminar como vitória definitiva, ou como exagero do Judiciário, seria perder o que ela tem de mais importante: a pergunta que ela coloca no centro do debate.
Essa pergunta não é apenas jurídica. É sobre os limites de poder das grandes plataformas sobre os dados, os conteúdos e a capacidade de expressão de pessoas, empresas e países.
Disponível não é o mesmo que liberado
Nenhuma criação nasce isolada. Jornalistas, artistas, pesquisadores e empresas trabalham a partir de repertórios e referências anteriores. Uma ideia geral não tem dono. O que vincula uma obra a quem a criou são as escolhas que lhe dão expressão: o recorte, a linguagem, a curadoria e a responsabilidade por aquilo que foi publicado.
Essa distinção evita dois erros opostos. O primeiro é tratar toda aprendizagem a partir de obras alheias como apropriação indevida, o que negaria como a cultura e a inovação sempre funcionaram. O segundo é concluir que tudo o que está acessível na rede virou matéria-prima livre para qualquer exploração econômica. A disponibilidade pública não equivale a uma licença ilimitada.
A IA torna essa fronteira mais sensível porque industrializa a aprendizagem. Uma pessoa lê e incorpora referências de modo limitado. Um modelo processa volumes imensos e se torna parte de um serviço global. A discussão deixa de ser só sobre o ato de copiar e passa a incluir a origem do dado, a finalidade, a escala, a substituição do original e a distribuição do valor gerado.
Estados Unidos: caso a caso, e a origem custa caro
Nos Estados Unidos, a análise passa pela doutrina do fair use, que pesa finalidade, transformação, natureza da obra, quantidade usada e efeito sobre o mercado original. Por isso as decisões recentes parecem apontar em direções diferentes.
Em Bartz v. Anthropic, em junho de 2025, um tribunal federal da Califórnia considerou o treinamento com livros adquiridos licitamente um uso transformativo. O mesmo julgamento, porém, não validou a obtenção e a manutenção de cópias piratas. O desfecho é eloquente: em julho de 2026, a Justiça homologou um acordo de US$ 1,5 bilhão com os autores, o maior da história do direito autoral americano. A lição não é que treinar é proibido. É que a origem do dado tem preço.
Dias depois, em Kadrey v. Meta, outro juiz federal deu vitória à Meta, mas com base nas provas daquele processo. A decisão não criou uma licença universal e deixou explícito que o dano ao mercado dos autores pode pesar contra o treinamento em outros casos.
No sentido oposto, em Thomson Reuters v. Ross Intelligence, um tribunal de Delaware rejeitou o fair use para o uso de conteúdo editorial do Westlaw no treinamento de uma ferramenta concorrente. Pesaram o caráter comercial e a concorrência direta. O caso está em recurso. A lição americana, até aqui: finalidade, origem e efeito econômico importam.
Europa: aprender padrões é uma coisa, substituir a fonte é outra
A União Europeia parte de outra lógica. A Diretiva de Direitos Autorais no Mercado Único Digital (2019/790) permite a mineração de textos e dados em obras acessadas licitamente, desde que o titular não tenha reservado seus direitos de forma legível por máquina.
A pergunta ampla, "é permitido treinar IA?", vira perguntas operacionais: a obra era acessível licitamente? Houve opt-out? O coletor podia reconhecê-lo? O AI Act acrescenta a obrigação de que fornecedores de modelos de propósito geral mantenham uma política de conformidade com direitos autorais.
O limite apareceu na Alemanha. Em GEMA v. OpenAI, em novembro de 2025, o Tribunal Regional de Munique entendeu que letras de música recuperáveis por comandos simples haviam sido memorizadas pelo modelo. Isso ultrapassou a análise estatística permitida e configurou reprodução não autorizada. O caso segue em recurso.
A opinião do advogado-geral em Like Company v. Google (processo C-250/25) vai na mesma direção. Ela sugere que o treinamento de modelos, em regra, cabe na exceção de mineração de dados, respeitadas as reservas de direitos. Mas aponta que buscar e reutilizar publicações de imprensa em tempo real para responder ao usuário pode infringir os direitos dos editores.
A opinião não vincula o Tribunal, que ainda vai decidir. Mas a distinção fala diretamente ao jornalismo: analisar um acervo é diferente de usar o conteúdo como substituto da fonte diante do leitor.
Noruega e Brasil: consentimento não é um clique
O caso brasileiro se aproxima do que aconteceu na Noruega. Em outubro de 2026, o Tribunal Distrital de Oslo suspendeu provisoriamente os novos termos comerciais da Meta após ação de grupos de mídia como Schibsted e NRK. Nos dois países, a discussão vai além do direito autoral. Chega ao poder de uma plataforma dominante de impor uma licença extensa como condição para que empresas continuem onde estão suas audiências.
Raramente usuários e empresas conseguem influenciar os termos dos serviços digitais de que dependem. Aceitamos contratos de adesão: regras definidas de antemão, pouca margem de negociação e consequências práticas para quem não concorda. A conta pode ser gratuita, mas a contrapartida envolve dados, conteúdo, atenção e relacionamento com o público.
Quando um veículo ou um negócio depende de uma plataforma para informar, vender ou manter contato com seu público, escolher entre aceitar ou perder alcance não é uma negociação entre iguais. Consentimento não é apenas um clique.
Transparência também não é publicar um texto extenso de termos de uso: é permitir que pessoas e organizações entendam o que autorizam e quais efeitos essa autorização pode ter.
A questão não é negar a necessidade de regras no ambiente digital, mas reconhecer a assimetria de poder de quem as escreve.
O passado que a liminar não apaga
Há uma pergunta que a decisão não responde: o que acontece com o conteúdo que já foi coletado e incorporado a bases de dados ou modelos? Em regra, uma liminar produz efeitos para frente. Ela impede novas condutas, mas não apaga o passado. Alcançá-lo exigiria provar a origem e o uso, discutir a possibilidade de remoção e eventual reparação.
O problema é que um modelo treinado não se parece com um arquivo que se apaga. Quando dados se incorporam aos parâmetros, identificar sua presença e removê-los pode ser técnica e juridicamente difícil. Remover uma instância da rede não elimina a capacidade de regenerá-la.
Por isso a governança precisa vir antes da coleta, e não depois que o problema se torna público. Rastreabilidade, documentação de fontes e registro de autorizações deixam de ser burocracia e passam a ser a única forma de responder, no futuro, à pergunta "de onde veio isso?".
Três testes que começam a convergir
Os Estados Unidos discutem fair use caso a caso. A Europa combina mineração de dados, opt-out e conformidade. A Alemanha testa os limites da memorização. Noruega e Brasil discutem contratos impostos por plataformas. Ferramentas diferentes, mas as perguntas que decidem os casos são cada vez mais parecidas:
- Origem. O dado foi obtido de forma lícita e com consentimento real, e não apenas formal?
- Substituição. O modelo aprende padrões ou entrega a obra no lugar da fonte original?
- Retorno de valor. Quem sustentou a criação participa do valor gerado com ela?
O terceiro teste é o mais difícil e o mais decisivo. Jornalismo profissional exige repórteres, editores, checagem, tecnologia, risco jurídico e tempo. Se a IA entrega respostas sintetizadas que encurtam o caminho até a fonte, e o retorno se concentra em quem coleta dados e vende acesso, a fonte que produziu o conhecimento perde a capacidade de continuar existindo.
Proteger a autoria, por outro lado, não pode significar congelar modelos de negócio. Veículos digitais e criadores independentes vivem de assinaturas, comunidades, serviços e licenças. O desafio é distribuir valor entre quem cria, quem licencia, quem desenvolve modelos, quem distribui e quem usa a IA para gerar resultado.
Uma agenda para o ecossistema da internet
Seria simplista tratar conteúdo jornalístico como sinônimo de neutralidade. Veículos fazem escolhas de pauta e enquadramento. Mas o jornalismo profissional tem atributos que importam para a qualidade da inteligência: apuração, autoria identificável, responsabilidade editorial, correção e direito de resposta. Se os sistemas de IA se afastarem dessas fontes sem critério, sua aprendizagem migra para páginas anônimas, redes sociais e fontes externas sem contexto local.
Há também uma dimensão de soberania cultural. Sistemas de IA já mediam busca, educação, comunicação e decisão. Se forem construídos sobretudo com referências externas, o Brasil perde contexto sobre sua história, suas regiões e seus desafios. Não é só uma questão de idioma. É a capacidade de o país narrar a si mesmo.
O Brasil não precisa escolher entre fechar-se à inovação e aceitar que sua produção intelectual seja extraída sem transparência. Para o ecossistema da internet, a agenda que esses casos desenham tem cinco frentes:
- Plataformas: termos de uso que separem o uso para distribuição do uso para treinamento, com escolha real e sem retaliação.
- Desenvolvedores de IA: documentação de fontes, respeito a reservas de direitos legíveis por máquina e controles contra memorização.
- Produtores de conteúdo: padrões técnicos de opt-out e modelos de licenciamento coletivo que deem escala à negociação.
- Empresas que usam IA: saber quais dados alimentam os sistemas que contratam e quem responde se uma resposta reproduzir obra protegida.
- Formuladores de políticas: regras claras de consentimento e rastreabilidade, construídas com diálogo entre todos os elos, sem bloquear a inovação.
A inteligência artificial pode ampliar o acesso ao conhecimento, a produtividade e a inovação. Mas, sem autoria, consentimento, rastreabilidade e remuneração, corre o risco de enfraquecer o próprio ecossistema de conteúdo do qual depende. O debate não é contra a IA. É a favor de uma internet em que a inteligência continue conectada a quem a produziu.
Texto de Dorian Lacerda Guimarães; pesquisa e revisão com apoio de ferramentas de IA, sob curadoria e responsabilidade do autor.
Fontes
- Olhar Digital – Justiça brasileira proíbe Meta de usar conteúdo jornalístico sem autorização (03/11/2026)
- Times Brasil – Justiça proíbe Meta de usar conteúdo jornalístico sem autorização
- TJUE – Opinião do advogado-geral no processo C-250/25, Like Company (03/11/2026)
- PPC Land – Tribunal norueguês bloqueia temporariamente os novos termos da Meta
- Jurist – Homologado acordo de US$ 1,5 bilhão em Bartz v. Anthropic (jul/2026)
- Bartz v. Anthropic PBC, Tribunal Distrital do Norte da Califórnia, ordem sobre fair use, 23/06/2025
- Kadrey v. Meta Platforms, Tribunal Distrital do Norte da Califórnia, 25/06/2025
- Thomson Reuters v. Ross Intelligence, Tribunal Distrital de Delaware, 11/02/2025
- GEMA v. OpenAI, Tribunal Regional de Munique, 11/11/2025
- Diretiva (UE) 2019/790, artigo 4 (mineração de textos e dados)
Leia também
IA não se rebelou. O que falhou foi a conexão.
Em “IA não se rebelou. O que falhou foi a conexão”, Dorian Lacerda analisa por que falhas de inteligência artificial não devem ser atribuídas a uma suposta vontade das máquinas, mas à ausência de governança, clareza de comandos, dados confiáveis e responsáveis definidos. O artigo relaciona IA, estratégia, operações, desenvolvimento humano e inteligência organizacional, propondo quatro perguntas essenciais para conselhos e lideranças. Também defende uma regulação brasileira baseada em princípios — transparência, rastreabilidade e supervisão humana proporcional ao risco — para que a IA acelere a tomada de decisões e a inovação sem enfraquecer a responsabilidade, a formação de talentos e a confiança.
A segunda metade da carreira precisa ser projetada
A primeira metade da carreira costuma ser conduzida por oportunidade e comparação. A segunda, se não for desenhada com intenção, é conduzida por inércia, e inércia raramente leva a um bom lugar.
Velocidade não é critério
A promessa mais vendida da IA corporativa é decidir mais rápido. Quase nenhuma organização mediu se está decidindo melhor, e as duas coisas não são a mesma.